Abres un CSV y donde ponía «España» aparece «España». O una web muestra rombos con interrogación en lugar de tildes. No es un virus ni un fichero roto: es un problema de codificación, y tiene una explicación exacta. Aquí verás qué son ASCII, Latin-1, Unicode y UTF-8, por qué se produce cada síntoma y cómo arreglarlo en los casos más típicos.
En resumen
- Un ordenador guarda bytes; la codificación es la tabla que dice qué letra es cada byte.
- «Ã±» aparece cuando un texto en UTF-8 se lee como Latin-1 o Windows-1252. «�» aparece en el caso contrario.
- La solución casi siempre es declarar UTF-8 en todos los puntos: fichero, programa, base de datos y conexión.
Qué es una codificación
Un fichero de texto no contiene letras, contiene bytes: números del 0 al 255. Para mostrar una «A», el programa necesita saber qué número corresponde a la «A». Esa correspondencia es la codificación.
Si quien escribe usa una tabla y quien lee usa otra, los bytes son los mismos pero las letras no. El fichero no se ha estropeado; se está interpretando mal.
ASCII, Latin-1 y Windows-1252
ASCII (1963) usa 7 bits: 128 caracteres. Letras inglesas, números, signos de puntuación y caracteres de control. No tiene ñ, ni tildes, ni €.
Para cubrir otros idiomas se usó el octavo bit, que da otros 128 huecos. Cada región los llenó a su manera:
- ISO-8859-1 (Latin-1): caracteres de Europa occidental. La ñ es el byte
F1, la é esE9. - Windows-1252: casi igual que Latin-1, pero aprovecha la zona
80–9Fpara caracteres como €, comillas tipográficas o el guion largo. Fue la codificación por defecto de Windows en España durante años y todavía la usan muchos programas.
El problema de estas tablas es que solo caben 256 caracteres. Un texto no podía mezclar español, griego y ruso, y cada país tenía su versión incompatible.
Unicode y UTF-8 no son lo mismo
Unicode es un catálogo: asigna un número único, llamado punto de código, a cada carácter de todos los sistemas de escritura, más símbolos y emojis. Se escribe como U+ y el número en hexadecimal: la ñ es U+00F1, la é es U+00E9 y el € es U+20AC.
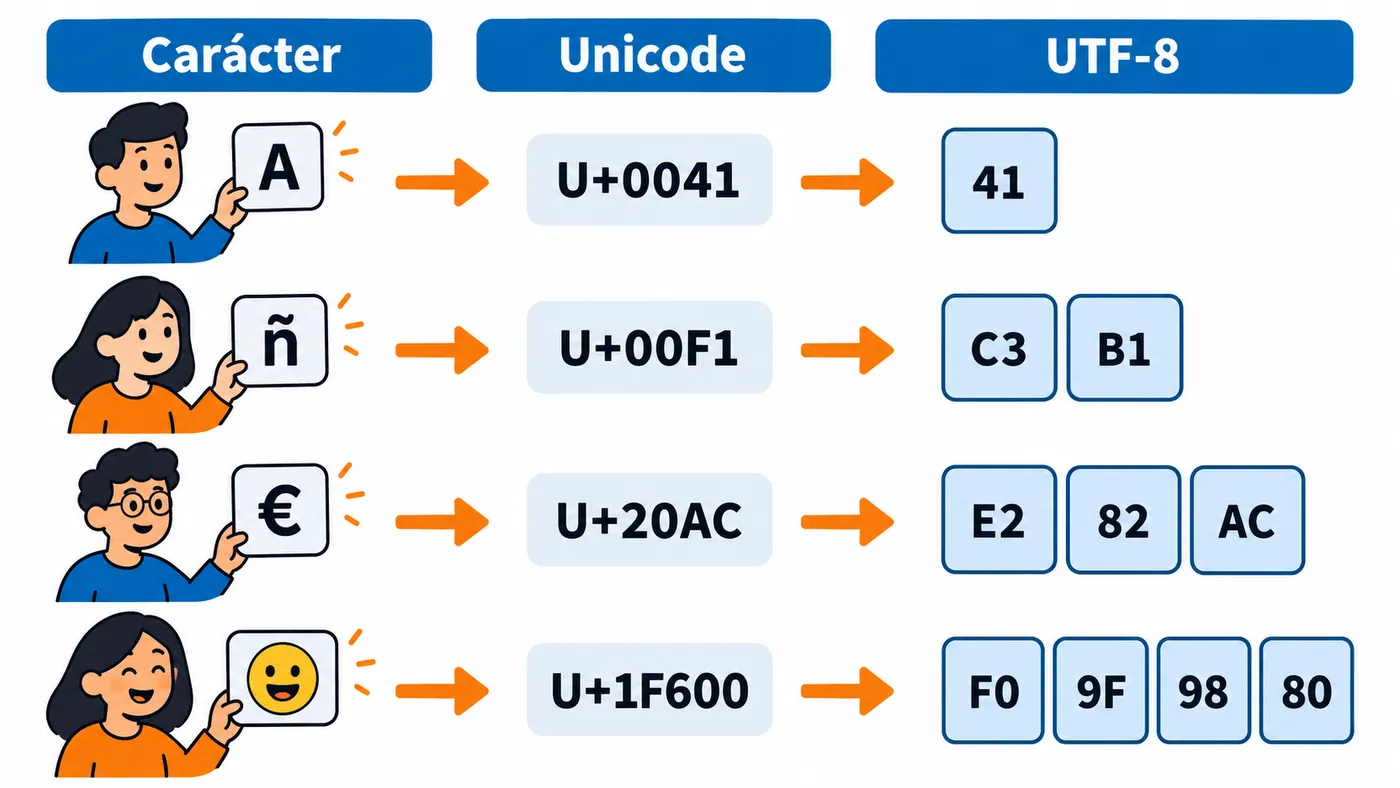
UTF-8 es una forma de guardar esos números en bytes. Usa entre 1 y 4 bytes según el carácter:
| Rango de punto de código | Bytes en UTF-8 | Ejemplos |
|---|---|---|
| U+0000 – U+007F | 1 | Letras inglesas, números (igual que ASCII) |
| U+0080 – U+07FF | 2 | ñ, á, é, ç, letras griegas y cirílicas |
| U+0800 – U+FFFF | 3 | €, la mayoría de caracteres chinos y japoneses |
| U+10000 – U+10FFFF | 4 | Emojis, símbolos poco frecuentes |
Su gran ventaja es que cualquier texto ASCII ya es UTF-8 válido. Por eso se impuso: hoy es la codificación de la inmensa mayoría de webs.
Existen también UTF-16 y UTF-32, que guardan los mismos puntos de código Unicode con unidades de 2 y 4 bytes. Windows los usa internamente, pero para ficheros e Internet lo habitual es UTF-8.
La misma letra, bytes distintos
Esta tabla es la clave de todo el artículo:
| Carácter | Unicode | Latin-1 / Windows-1252 | UTF-8 |
|---|---|---|---|
| A | U+0041 | 41 | 41 |
| ñ | U+00F1 | F1 | C3 B1 |
| é | U+00E9 | E9 | C3 A9 |
| á | U+00E1 | E1 | C3 A1 |
| ó | U+00F3 | F3 | C3 B3 |
| € | U+20AC | 80 (solo Windows-1252) | E2 82 AC |
Las letras inglesas coinciden. Las que llevan tilde o la ñ ocupan un byte en Latin-1 y dos en UTF-8.
Puedes comprobarlo tú mismo en macOS o Linux:
printf 'ñ' | xxd
# 00000000: c3b1
El mojibake explicado
Al texto desfigurado por una codificación equivocada se le llama mojibake. Hay dos direcciones posibles y cada una deja una huella distinta.
Caso 1: UTF-8 leído como Windows-1252 (sale ñ)
La ñ en UTF-8 son dos bytes: C3 B1. Un programa que cree estar leyendo Windows-1252 los interpreta uno a uno:
C3en Windows-1252 es ÃB1en Windows-1252 es ±
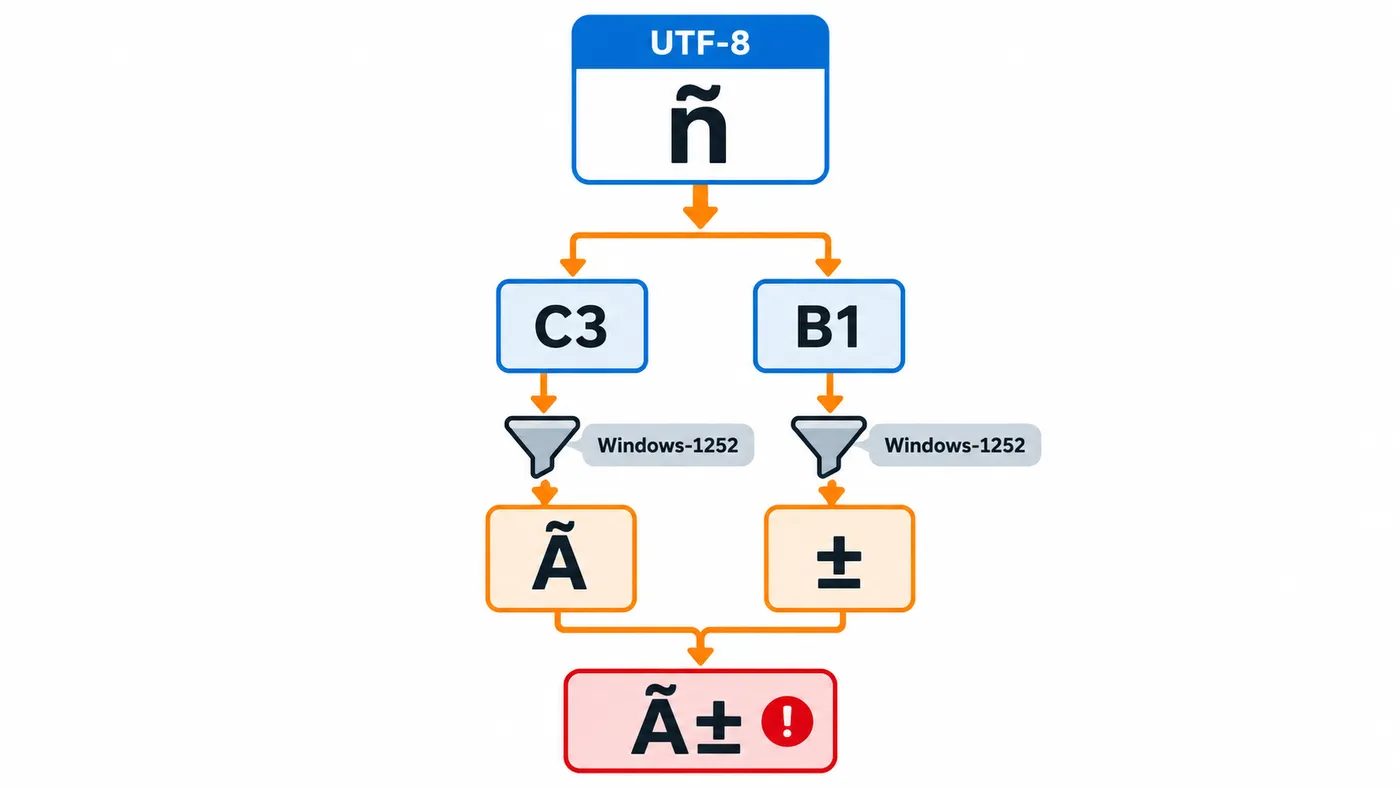
Resultado: «Ã±». Por eso todos los errores de este tipo empiezan por Ã: las letras acentuadas del español comparten el primer byte C3.
| Escribiste | Ves | Por qué |
|---|---|---|
| ñ | ñ | C3 B1 |
| é | é | C3 A9 |
| á | á | C3 A1 |
| ó | ó | C3 B3 |
| ú | ú | C3 BA |
| í | Ã | C3 AD: el AD es un guion invisible |
| € | € | E2 82 AC |
La í es la más traicionera: parece que solo queda una «Ã» suelta porque el segundo byte no se ve.
Caso 2: Windows-1252 leído como UTF-8 (sale �)
Ahora al revés. La ñ en Windows-1252 es un solo byte, F1. En UTF-8, un byte F1 anuncia el inicio de un carácter de 4 bytes, y los siguientes no encajan. El programa no puede descifrarlo y pone el carácter de sustitución �, U+FFFD.
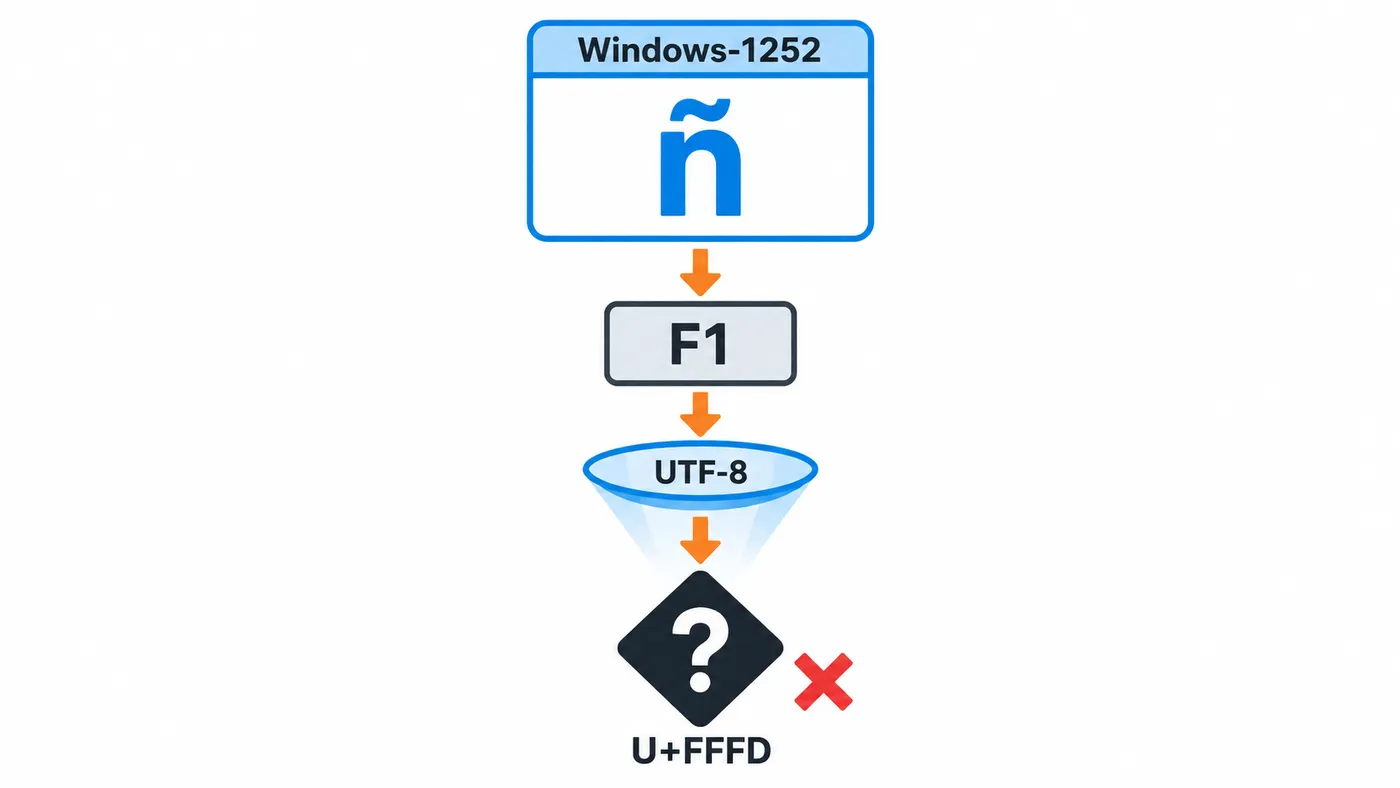
Pista rápida: si ves Ã, el fichero es UTF-8 y lo lees mal; si ves �, el fichero no es UTF-8 y lo lees como si lo fuera.
Caso 3: doble codificación
Si un texto ya roto («Ã±») se vuelve a guardar como UTF-8 y se vuelve a leer mal, el destrozo crece: «ÃƒÂ±». Cada capa añade más caracteres. Suele pasar al copiar datos entre sistemas varias veces.
Casos típicos y cómo arreglarlos
CSV en Excel
Es el caso más común. Una web o programa exporta un CSV en UTF-8 y Excel para Windows lo abre con la codificación regional, Windows-1252, si el fichero no lleva BOM.
Soluciones:
- En Excel, usa Datos › Desde texto/CSV y elige como origen 65001: Unicode (UTF-8).
- Si generas tú el CSV, guárdalo con BOM: Excel lo detecta y lo abre bien con doble clic.
- Al guardar desde Excel, elige el formato CSV UTF-8 (delimitado por comas), no el «CSV» a secas.
El BOM
El BOM (Byte Order Mark) son tres bytes, EF BB BF, al principio de un fichero UTF-8 para marcar su codificación. A Excel le ayuda, pero otros programas lo tratan como texto. Leído como Windows-1252 aparece como  al inicio, y en scripts y ficheros de configuración puede provocar errores en la primera línea.
Regla práctica: con BOM para CSV que se abrirán en Excel; sin BOM para código, configuración y web.
Correos electrónicos
Un correo indica su codificación en la cabecera Content-Type. Si el programa que lo envía declara una codificación y escribe en otra, el destinatario ve mojibake. Si generas correos desde una web o script, asegúrate de enviar charset=UTF-8 y de que el texto esté realmente en UTF-8.
Páginas web
La página debe declarar la codificación con la etiqueta meta al principio del head y el servidor debería enviarla en la cabecera HTTP:
<meta charset="utf-8">
Content-Type: text/html; charset=utf-8
Bases de datos
En MySQL y MariaDB, el juego de caracteres utf8 es en realidad una versión limitada a 3 bytes: no admite emojis. Usa utf8mb4. Además, la conexión entre la aplicación y la base de datos también tiene codificación propia; si no coincide, se guarda texto ya roto.
CREATE DATABASE tienda CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci;
SET NAMES utf8mb4;
Cómo detectar y convertir ficheros
Para saber qué codificación tiene un fichero:
file -i datos.csv   # Linux
file -I datos.csv   # macOS
Para convertir de Windows-1252 a UTF-8:
iconv -f WINDOWS-1252 -t UTF-8 datos.csv > datos-utf8.csv
En PowerShell 7 puedes indicar la codificación al leer y al escribir:
Get-Content .\datos.csv -Encoding windows-1252 | Set-Content .\datos-utf8.csv -Encoding utf8
Si el texto ya está roto con «Ã±» (UTF-8 mal leído y guardado), se puede revertir deshaciendo el paso equivocado:
roto = "España"
arreglado = roto.encode("cp1252").decode("utf-8")
print(arreglado)  # España
Funciona solo si no se ha perdido información por el camino. Con «�» no hay vuelta atrás: el carácter original ya se ha sustituido.
Errores habituales
- Convertir dos veces: pasar a UTF-8 un fichero que ya era UTF-8 crea doble codificación. Comprueba antes con
file. - Arreglarlo a mano con buscar y reemplazar: funciona con la ñ y falla con la í y otros casos. Mejor revertir la codificación.
- Confiar en «utf8» de MySQL: usa
utf8mb4siempre. - Dar por hecho la codificación de PowerShell: Windows PowerShell 5.1 y PowerShell 7 no escriben por defecto en la misma codificación. Indica
-Encodingde forma explícita. - Declarar UTF-8 y guardar en otra cosa: la etiqueta no convierte nada; el fichero debe estar realmente guardado en UTF-8.